Поиск
Фондовый рынок


Вашингтон ограничивает китайским разработчикам доступ к передовым вычислительным мощностям, но полностью перекрыть передачу знаний из американских нейросетей куда сложнее. Китайские модели ИИ обучают на ответах OpenAI, превращая результаты работы дорогостоящих систем в материал для собственных конкурентов. Анализ более 300 научных статей, патентов, корпоративных документов и государственных материалов, проведённый Reuters, показал, насколько далеко такая практика вышла за пределы отдельных университетских экспериментов. В центре истории не секретный исходный код и не похищенные серверы, а результаты работы моделей, к которым разработчики получили доступ.
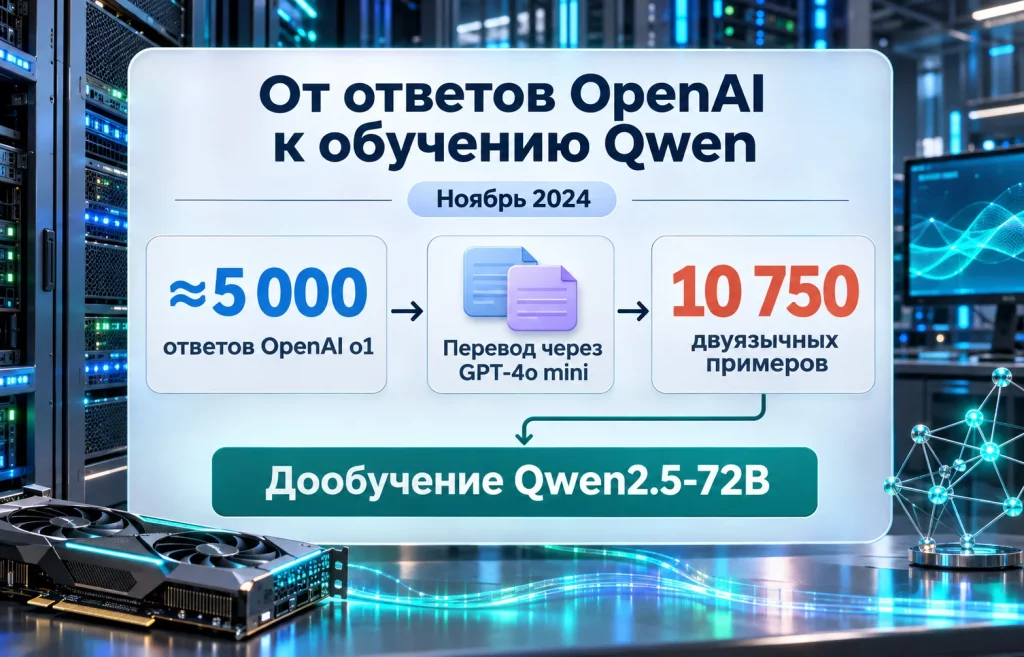
В ноябре 2024 года исследователи Шанхайского университета Цзяотун описали способ получить большой обучающий набор из относительно небольшого числа ответов американской модели. Они отобрали около 5000 ответов OpenAI o1, использовали GPT-4o mini для перевода и сформировали 10 750 двуязычных примеров. Затем эти материалы пошли на дополнительное обучение Qwen2.5-72B от Alibaba.
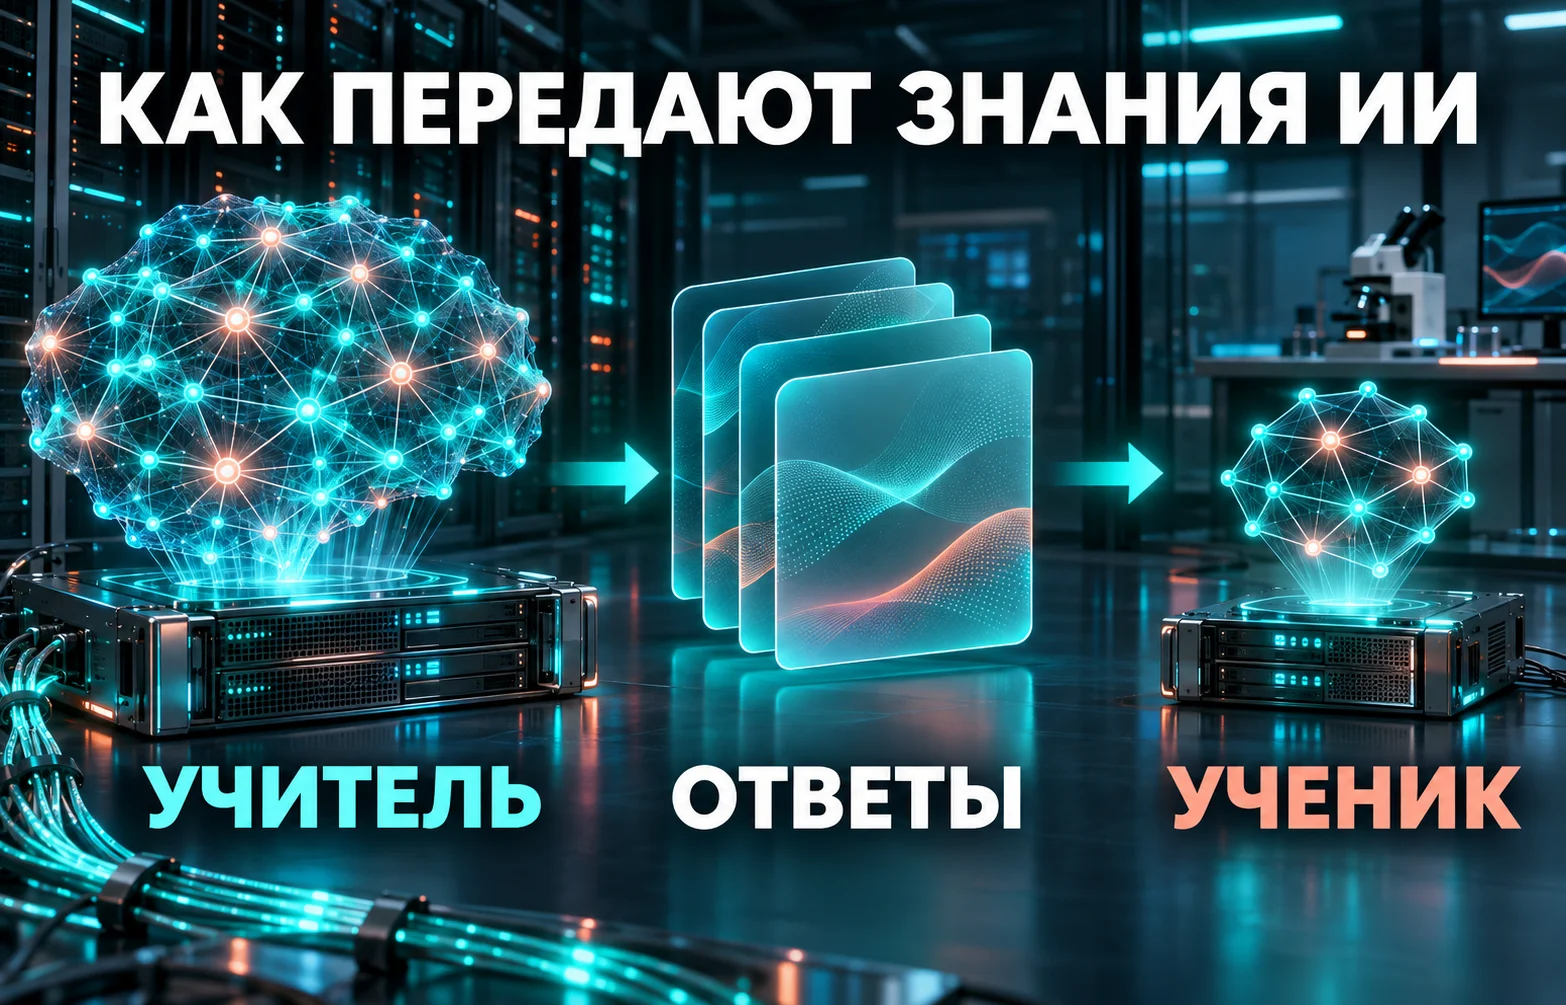
Здесь скрыта суть дистилляции знаний. Вместо того чтобы заставлять собственную модель самостоятельно проходить весь путь поиска ответа, разработчик даёт ей образцы работы более мощного «учителя». Ученик не получает веса нейросети, её внутренние параметры или полный алгоритм. Он видит примеры решений и постепенно учится воспроизводить отдельные полезные приёмы.
Для пользователя разница может быть почти незаметной. Если относительно компактная система достаточно хорошо справляется с конкретной задачей, компании не требуется каждый раз обращаться к более дорогому внешнему сервису. Но на уровне разработки разница огромна. Один набор подготовленных примеров можно многократно использовать для обучения, проверки и улучшения локальной модели.
В исследовании университета важны три разных действия:
Исследователи признали и слабое место метода. Чрезмерная опора на чужие результаты может тормозить собственные открытия: модель успешно повторяет знакомую схему, но хуже справляется с новым классом задач, для которого у учителя не запросили подходящих примеров. Так возникает особая зависимость. Можно сократить расходы на получение отдельных навыков, но источник следующего технологического прорыва по-прежнему находится за пределами команды.
Есть и вопрос масштаба. Десятки тысяч примеров способны помочь при дообучении, однако это не равнозначно обучению передовой универсальной модели с нуля. Дистилляция передаёт выбранные способности; её эффективность зависит от качества запросов, отбора ответов и архитектуры ученика. Когда задачи меняются, накопленный набор может оказаться недостаточным.
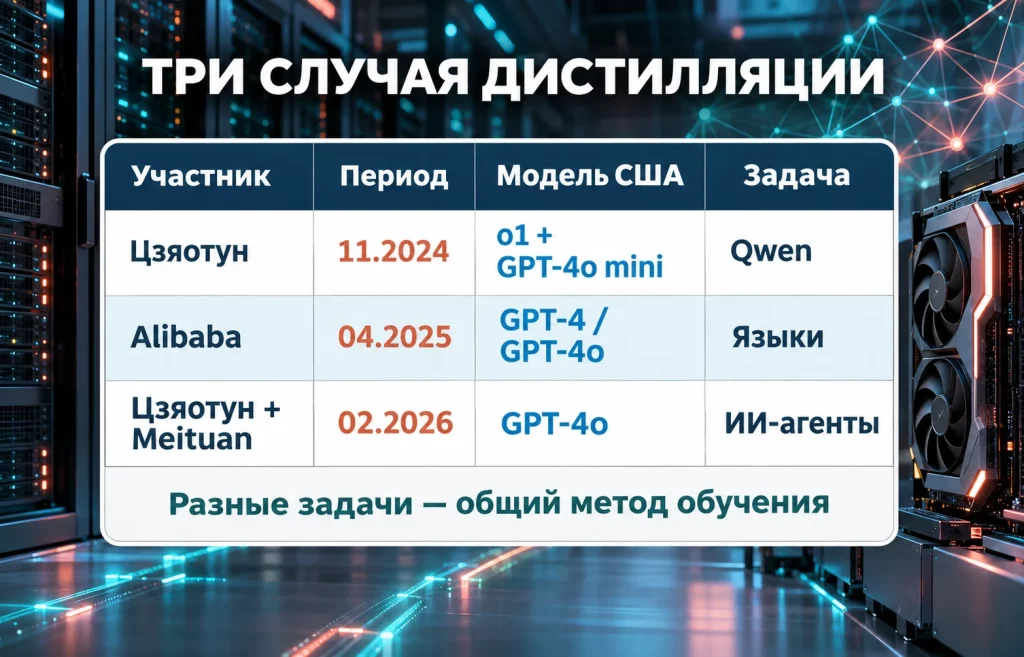
Академический эксперимент быстро перестаёт быть единичным примером, когда к похожим методам обращаются крупные технологические компании. Alibaba и Meituan использовали американские модели по-разному. Именно различие задач показывает, насколько универсальным инструментом стала дистилляция.
В апреле 2025 года исследователи Alibaba описали создание учебных материалов для моделей Qwen с помощью GPT-4 и GPT-4o. Американские системы генерировали ответы на языках, отличных от китайского. Затем материал дополнительно обрабатывали, оценивали и отбирали. Это не механическое копирование текста: качество ученика зависит от того, какие примеры проходят фильтр и насколько хорошо они соответствуют будущим задачам.
Для Alibaba такая работа имеет коммерческое продолжение. Чем эффективнее Qwen на разных языках, тем больше сценариев можно обслуживать собственными моделями, не оплачивая каждый пользовательский запрос стороннему поставщику. Конкуренция идёт не только за лидерство в тестах. Компаниям нужны инструменты для облачных сервисов, бизнеса и разработчиков. Поэтому развитие линейки Qwen и её экономики связано и с борьбой за стоимость обработки запросов, и с желанием удерживать клиентов внутри собственной технологической платформы.
Другой пример появился в феврале 2026 года. Исследователи университета Цзяотун и компании Meituan привлекли GPT-4o для создания планов взаимодействия ИИ-агентов, решающих задачи программирования. Обучаемая компактная модель должна была не просто написать фрагмент кода, а помогать организовывать последовательность работы нескольких участников.
Такие задачи сложнее обычного вопроса с коротким ответом. Агентам требуется делить проблему на части, распределять действия, проверять промежуточные результаты и при необходимости менять план. В этом случае американский «учитель» передаёт примеры организации процесса, а не собственную программную архитектуру. Похожая последовательность шагов может оказаться полезнее, чем ещё одна готовая строчка кода.
У двух кейсов разные цели. Alibaba расширяет возможности языковых моделей; исследователи вместе с Meituan работают над планированием действий ИИ-агентов. Объединяет их возможность сохранить результат дорогостоящей генерации и использовать его для обучения более доступного инструмента. По мере роста числа таких специализированных моделей ценность отдельных обучающих наборов повышается: они становятся производственным ресурсом наряду с вычислениями и командами инженеров.
При этом китайские компании не обязаны использовать один и тот же источник данных. В разработке крупных моделей сочетаются оригинальные корпуса, собственные алгоритмы, переработанные результаты других систем и ручная оценка качества. Документированные случаи с GPT не доказывают, что весь прогресс китайского ИИ построен на американских ответах.
Американские ограничения сосредоточены прежде всего на оборудовании и доступе к высокопроизводительным вычислениям. 16 ноября 2026 года Бюро промышленности и безопасности США (BIS) сообщило о новых правилах для удалённого использования передовых чипов и серверов через дата-центры третьих стран. Вашингтон пытается закрыть ситуацию, при которой запрещённое к поставке оборудование физически находится за пределами Китая, но вычислительные мощности доступны китайскому заказчику через облако.
Дистилляция действует на другом уровне. Разработчик может получить ответ модели, изучить образец решения и использовать его при обучении собственной системы. Отсюда конфликт: экспортный контроль регулирует доступ к оборудованию, а поведение пользователей ИИ-сервисов регулируется прежде всего условиями самих поставщиков, механизмами защиты и применимым законодательством. Эти контуры пересекаются, но не совпадают.
Такой перенос не бесплатен. Для обучения ученика тоже нужны процессоры, память, энергия и квалифицированные инженеры. Не исчезают расходы на проверку данных, повторные попытки обучения и последующий запуск модели в реальном продукте. Экономический смысл появляется, когда стоимость многократного использования подготовленного навыка оказывается ниже постоянных обращений к внешнему «учителю» при сопоставимом качестве.
У небольших специализированных моделей есть ещё одно достоинство. Производителю оборудования или разработчику корпоративного приложения не всегда требуется универсальная нейросеть, способная рассуждать обо всём. Иногда достаточно уверенной работы с инструкциями, отраслевыми документами, кодом или типовыми производственными заданиями. Более узкий инструмент можно внедрить ближе к месту применения и контролировать его затраты.
Пекин рассматривает этот подход как часть промышленной политики. В опубликованных 7 января 2026 года официальных рекомендациях по программе «ИИ + производство» восемь китайских ведомств поддержали развитие обучения, донастройки и дистилляции моделей для предприятий. Документ не предписывает заимствовать ответы именно у OpenAI. Его цель шире: сделать искусственный интеллект пригодным для работы в промышленности, где стоимость и надёжность часто важнее рекордов на академических тестах.
Вопрос для китайских компаний теперь двойной. Как обеспечить достаточные вычислительные ресурсы для новых разработок и как превратить накопленные знания в продукты, за которые клиенты готовы платить? Рынок оценивает не только возможности моделей, но и вероятность будущей прибыли. На этом фоне разочарование инвесторов в китайском ИИ-буме показывает, что стратегическая ценность технологии и её биржевая оценка могут расходиться.
Американский чиповый заслон поэтому нельзя назвать ни полностью бесполезным, ни непроницаемым. Он повышает цену некоторых вычислительных путей и ограничивает доступ к самым мощным ускорителям. Но доступные ответы уже обученных систем могут облегчать развитие отдельных функций на существующем оборудовании. Получить пример решения легче, чем воспроизвести всю исследовательскую и вычислительную инфраструктуру, которая позволила его создать.
В технологическом смысле дистилляция не является незаконной сама по себе. Её используют исследователи и компании по всему миру, в том числе для уменьшения размеров собственных моделей. Юридический конфликт появляется тогда, когда данные получают и применяют вопреки условиям доступа, лицензиям или другим защищаемым правам.
У OpenAI есть прямое договорное ограничение: клиентам запрещено использовать результаты работы сервисов для разработки конкурирующих ИИ-моделей, кроме предусмотренных исключений. Anthropic также ограничивает подобное обучение без разрешения. Поэтому доступность ответа через обычный интерфейс ещё не означает, что любой способ его последующего коммерческого использования разрешён.
Американские разработчики пытаются защищать результаты крупных инвестиций в обучение передовых систем. Если конкурент может купить относительно небольшое количество ответов, а затем обучить на них собственного более дешёвого помощника, ценность исходного сервиса может снижаться. Но здесь возникают разные правовые вопросы, и смешивать их нельзя:
Именно поэтому спор уже вышел за пределы пользовательских соглашений. На встречах в Чэнду в июле американские представители подняли вопрос о масштабном сборе ответов передовых моделей китайскими разработчиками. Американская сторона предупредила о рисках нарушения интеллектуальной собственности. Представители Китая, согласно изложению переговоров, отстаивали дистилляцию как распространённый метод и выражали готовность реагировать на доказанные нарушения, но конкретных обязательств по ограничению практики не приняли.
Для Вашингтона это вопрос эффективности экспортной политики и сохранения технологического преимущества. Для китайских компаний — возможность быстрее осваивать прикладные навыки, пока доступ к части оборудования ограничен. При этом разработчики в обеих странах заинтересованы в правилах, которые защищают собственные модели и не блокируют обычные исследования. Конфликт уже затрагивает борьбу американских ИИ-компаний с несанкционированной дистилляцией, но наличие претензий не заменяет решения суда по каждому отдельному случаю.
Разногласие касается и оценки результатов. Один американский чиновник связывает сокращение технологического разрыва прежде всего с промышленной дистилляцией. Представители китайской отрасли указывают на другие факторы: инженерные решения, архитектуру моделей, алгоритмы и собственные наборы данных. Документы подтверждают использование отдельных американских систем, но не позволяют точно измерить долю заимствованных навыков во всех достижениях китайского ИИ.
Китайские модели ИИ получают практическое преимущество там, где ответы мощных американских систем удаётся превратить в качественные обучающие примеры. Для специализированного бизнеса это способ быстрее вывести продукт и уменьшить зависимость от дорогих внешних запросов. Обратная сторона той же стратегии — риск отстать в собственных открытиях, остаться зависимыми от вычислительного оборудования и столкнуться с претензиями правообладателей.
Следующий этап конкуренции решится не одним запретом и не одним удачным экспериментом. США могут жёстче контролировать доступ к передовым вычислениям и использование результатов своих моделей; Китай — расширять собственную исследовательскую базу и искать законные способы переноса знаний. Между этими стратегиями останется главный вопрос: кто сумеет создавать новые способности ИИ самостоятельно, а не только быстрее и дешевле воспроизводить уже найденные решения?
Больше новостей здесь.
Полезное
Падение альткоинов: 27 из 40 потеряли...
Ископаемое топливо теряет два рынка: Эл...
Дефицит ликвидности банков России: 4 трлн...
Дайджест криптоновостей за 16.11.2026:...
Котировки железной руды: фьючерсы КНР на...
Мировой фондовый рынок: Азия падает,...
Если ИИ заменит людей, зачем будет нужен...
Биржа Hyperliquid обошла Bybit, Kraken и...
Добыча редкоземельных металлов: ставка на...
Интервенция США в поддержку иены: лишь...
Другие новости
Срочный рынок
Ископаемое топливо теряет два рынка: Эл Гор на COP31
Финансовый рынок
Дефицит ликвидности банков России: 4 трлн и петля ОФЗ
Финансовый рынок
Трамп пригрозил ЕС новыми пошлинами из-за Канады
Срочный рынок
Новые санкции США против России одобрил Конгресс
Фондовый рынок
Ставка ФРС выросла до 3,75–4%: цикл развернулся
Срочный рынок
Производство стали в Китае снижается вслед за спросом
Финансовый рынок
DXY снижается: рынки ждут паузу ФРС
Фондовый рынок
CXMT стала самой дорогой компанией Китая: что это значит?